Últimamente parece que estamos de enhorabuena respecto a los estudios
procedentes de España, que es el país desde donde os escribimos. Y,
curiosamente, el último estudio que os comentamos también hablaba sobre
el cannabis o marihuana, pero aquella vez se trataba del uso de aceite de cannabis para tratar la fibromialgia, eliminando su componente psicoactivo. Esta vez no hablaremos de sus beneficios, sino precisamente de los males que puede provocar este componente, el tetrahidrocannabinol, pues se sabía que podía llegar a provocar algunos trastornos mentales por su abuso. Ahora ya sabemos como lo hace.
El origen de la esquizofrenia a nivel cerebral
El estudio, llevado a cabo por los investigadores del Consejo superior de Investigaciones Científicas (CSIC) de España, y dirigido por Javier Garzón Niño, del Instituto Cajal, ha descubierto como los cannabinoides controlan la activación de algunas áreas nerviosas del cerebro. De igual forma, el
consumo desordenado de la sustancia desactiva un mecanismo con más
intensidad de la necesaria, dando lugar a los temidos trastornos
mentales como pueden ser la esquizofrenia o la psicosis.
Algunas alteraciones en los neurotransmisores como son el glutamato y la dopamina, cuando coinciden en unas áreas cerebrales específicas, se manifiestan en forma de diferentes conductas como podría ser la esquizofrenia.
Existen factores genéticos que hacen a unos individuos más vulnerables
que otros a la enfermedad, pero si nos fijamos en los factores
ambientales o malos hábitos como es el consumo de cannabis u otras
drogas, las cosas pueden acelerarse (e incluso aumentar su intensidad).
Según un estudio sistémico de las posibles alteraciones genéticas y epigenéticas, la
alteración del sistema nervioso no sería la principal causa de la
aparición de la esquizofrenia, sino que se debería fundamentalmente a
una mala función de un receptor determinado del glutamato: El NMDAR.
Por ello, al no haber suficiente glutamato para contrarrestar, la
dopamina aumenta su efecto y acaba provocando la psicosis y la
esquizofrenia.
El papel del cannabis en la esquizofrenia
Esencialmente, el sistema cannabinoide endógeno que poseemos desde el
nacimiento es bueno, ya que controla la unión del glutamato a su
receptor NMDAR y da lugar a procesos neurológicos como son la memoria o el aprendizaje. Los cannabinoides inhiben este receptor, y así se mantiene todo el sistema en un equilibrio fisiológico sin alteraciones.
-
Sin embargo, como todo equilibrio, el sistema es delicado y tiene sus puntos débiles. Aquí es donde entran en juego los cannabinoides exógenos o externos, es decir, el abuso de la marihuana. Su
consumo aumenta de forma desproporcionada la inhibición del receptor
NMDAR del neurotransmisor glutamato, dando lugar a un mayor efecto de la
dopamina de forma intensa, y finalmente provocando la psicosis.
Para evitar que todo esto suceda, se ponen en marcha mecanismos de liberación del receptor NMDAR, pero todo esto puede desconectar el sistema, dando lugar a una vulnerabilidad que provocaría la esquizofrenia.
-
Así lo explica el investigador principal, Javier Garzón:
“El abuso del cannabis rompe el preciado equilibrio entre
excitación (NMDAR) e inhibición (cannabinoides endógenos) y empuja el
plato de la balanza hacia la inhibición, y por tanto permite una mayor
actividad de aquellos otros sistemas controlados negativamente por el
NMDAR, como el dopaminérgico”
Finalmente, según comentan los investigadores del CSIC, si se
abusa del consumo inhalado de esta sustancia se pueden producir cuadros
de psicosis reversibles. Pero si se sigue repitiendo la mala conducta,
los daños del sistema nervioso pueden ser duraderos. Además, si a esto le sumamos una predisposición genética, la facilidad para llegar a la esquizofrenia es todavía mayor.
La inteligencia artificial hackea el cerebro humano
Mientras médicos y científicos avanzan en los estudios para entender los engranajes del cerebro humano, la inteligencia artificial (IA) ya es capaz de hackearlo.
Ya existen sistemas de IA para tratar síntomas de la depresión,
softwares de aprendizaje automático capaces de reconocer cambios
cerebrales causados por el Alzhéimer años antes de las primeras señales o
escaneos cerebrales que identifican tendencias suicidas.
En el caso del Alzheimer –la principal causa de la demencia en
ancianos–, el mayor desafío es lograr un diagnóstico temprano y frenar
su progresión. En ese sentido, un equipo liderado por Marianna La Rocca,
física de la Universidad de Bari, en Italia, desarrolló un algoritmo de aprendizaje automático capaz de discernir cambios estructurales en el cerebro causados por el Alzheimer.
El algoritmo fue entrenado con 67 imágenes de resonancia magnética
–38 de pacientes con Alzheimer y 29 de un grupo de control– para que
aprendiera a discriminar correctamente entre cerebros enfermos y sanos.
Los investigadores dividieron cada imagen cerebral en pequeñas regiones,
analizaron la conectividad neuronal entre ellas y encontraron que el software había realizado la clasificación más precisa de la enfermedad
al comparar regiones cerebrales de 2.250 a 3.200 milímetros cúbicos,
tamaño similar al de las estructuras anatómicas relacionadas con el
Alzheimer, como el hipocampo.
El
algoritmo para detectar los cambios cerebrales que llevan al alzheimer
fue entrenado con imágenes de resonancia magnética. Crédito: Mikkelwallentin
Al analizar un conjunto de 148 escaneos —52 sanos, 48 enfermos y 48
con deterioro cognitivo leve, de los que se sabía que desarrollarían la
enfermedad de 2,5 a nueve años más tarde—, el sistema distinguió entre un cerebro sano y uno con Alzheimer con una precisión del 86%.
Para La Rocca, esto muestra que el algoritmo podría identificar cambios
en el cerebro que conducen al Alzheimer casi una década antes de los
síntomas clínicos.
“Actualmente, los escaneos cerebrales con trazadores radioactivos son
capaces de predecir con relativa precisión quién está en alto riesgo de
desarrollar Alzheimer dentro de 10 años, pero ese es un método
invasivo, caro y que solo está disponible en centros altamente
especializados. La nueva técnica, sin embargo, es más simples, más barata y no invasiva“, afirma la científica, que pretende aplicar el método en el diagnóstico precoz de enfermedades como el Párkinson.
Un algoritmo que identifica potenciales suicidas
Un grupo de psicólogos y psiquiatras de diferentes universidades estadounidenses desarrollaron un algoritmo similar para identificar a suicidas en potencia.
Sometieron a 34 adultos jóvenes —divididos entre suicidas y un grupo de
control— a una resonancia magnética funcional (fMRI) y les presentaron
tres listas de 10 palabras: una relacionada con el suicidio (“muerte”,
“fatal” o “angustiado”), otra con cosas positivas (“bondad” o
“inocencia”) y otra con la negatividad (“aburrimiento” o “maldad”).
Se utilizaron imágenes cerebrales previamente mapeadas que muestran
patrones emocionales como el de la vergüenza o la ira. Los científicos
identificaron cinco ubicaciones cerebrales, relacionadas con seis de las
palabras, como los mejores marcadores para distinguir a los pacientes
suicidas de los demás. Con eso, entrenaron un clasificador de aprendizaje automático que pudo identificar correctamente a 15 de los 17pacientes suicidas y a 16 de 17 sujetos de control.
Tras esto, dividieron a los pacientes suicidas en dos grupos, los que
habían intentado suicidarse (nueve) y los que no (ocho), y entrenaron a
un nuevo clasificador que pudo identificar correctamente a 16 de los 17
pacientes.
Patrón
de activación cerebral para “muerte” en participantes que habían hecho
un intento de suicidio, izquierda, en comparación con los participantes
control, derecha. Crédito: Credit: Carnegie Mellon University
Los resultados mostraron que los pacientes sanos y aquellos con
pensamientos suicidas tenían reacciones marcadamente diferentes ante las
palabras. Cuando aquellos con tendencias suicidas veían la palabra
“muerte”, el área de vergüenza de su cerebro registraba un pico de
actividad no observado en el grupo de control. Lo mismo ocurría en el
área de tristeza con la palabra “problemas”. “Esto nos da una ventana al
cerebro y la mente, nos permite decir si alguien está considerando suicidarse por la forma en que piensa en los temas relacionados con la muerte“, explica Marcel Just, catedrático de Psicología de la Universidad Carnegie Mellon.
IA para tratar la depresión
Además de ayudar a diagnosticar
enfermedades y trastornos mentales, la IA puede ayudar a tratarlos. Es
lo que creen los creadores de start-ups como Woebot, un chatbot que
utiliza el aprendizaje automático y el procesamiento del lenguaje
natural para ayudar a los usuarios a controlar su estado de ánimo y mitigar la depresión.
Thomas Insel utiliza IA para diagnosticar trastornos emocionales mediante la interpretación del uso de smartphones. Crédito: Hamza Butt
Con acceso a través de Facebook Messenger, el
sistema hace preguntas a los usuarios para evaluar su estado de ánimo.
Con el tiempo, el algoritmo, entrenado en métodos de terapia
cognitivo-conductual, aprende el perfil emocional de cada uno y
recomienda actividades para mantener su equilibrio. Un ensayo clínico realizado en colaboración con la Universidad de Stanford demostró que usuarios de entre 18 y 28 años experimentaron reducciones significativas en la ansiedad y la depresión en comparación con el grupo de control que utilizó un libro sobre cómo lidiar con la depresión.
Otra iniciativa es la de Thomas Insel, exdirector del Instituto Nacional de Salud Mental de Estados Unidos, fundador de Mindstrong,
que utiliza IA para ayudar a diagnosticar y tratar trastornos de
comportamiento y emocionales mediante la interpretación del uso de
smartphones. Partiendo del presupuesto de que los usuarios utilizan sus móviles de maneras diferentes según su estado emocional,
el algoritmo utiliza la “fenotipificación digital” —un método de
cuantificación de características individuales mediante el análisis de
datos generados por el uso individual de dispositivos digitales— para
sugerir correlaciones entre actividades digitales específicas y la
actividad cerebral. “Los trastornos psicológicos y emocionales son un
problema de salud global. Los smartphones con IA pueden ser una solución
global”, sostiene Insel.
El próximo paso: la vida
exponencial presenta una visión, forzosamente parcial y esquemática, del
potencial de las llamadas «tecnologías exponenciales» y sus
implicaciones económicas, sociales, medioambientales, éticas e, incluso,
ontológicas.
La idea fundamental que recorre el libro es que la humanidad se
encuentra en los inicios de una revolución tecnológica de desarrollo
acelerado, en comparación con otras anteriores, y de un alcance tal que
va a generar transformaciones que solo comenzamos a imaginar.
Las tecnologías que están emergiendo van a cambiar, están cambiando
ya, lo que parecían constantes fundamentales de la naturaleza humana:
hoy parece posible mejorar drásticamente la memoria de las personas, sus
procesos cognitivos, sus capacidades físicas e intelectuales, y
aumentar la longitud de su vida hasta extremos que pueden cambiar
nuestro concepto de mortalidad. Junto con las inmensas posibilidades que
todo esto supone, plantea también incógnitas muy relevantes para la
especie humana.
¿Deberían preocuparnos los riesgos a largo plazo de la
inteligencia artificial superinteligente? En caso afirmativo, ¿qué
podemos hacer al respecto? Aunque parte de la comunidad mayoritaria de
la inteligencia artificial ignora estas preocupaciones, yo argumentaré
que es necesaria una reorientación fundamental del campo. En lugar de
construir sistemas que optimicen objetivos arbitrarios, necesitamos
aprender a construir sistemas que nos resulten probadamente
beneficiosos. Demostraré la utilidad de dotar a los sistemas de
incertidumbre explícita referida respecto a los objetivos de los humanos
a los que tienen que ayudar, pues para ello han sido diseñados.
El objetivo
de la investigación en inteligencia artificial (IA) ha sido comprender
los principios que subyacen en el comportamiento inteligente y
aplicarlos a la construcción de máquinas capaces de presentar dicho
comportamiento. En los 50 años de vida de la disciplina se han buscado
distintas definiciones de «inteligente», incluida la emulación del
comportamiento humano y la capacidad de razonamiento lógico. En décadas
recientes, sin embargo, ha surgido un consenso en torno a la idea de un
agente racional que percibe y actúa para alcanzar sus objetivos al
máximo. Subcampos como la robótica y el procesamiento de lenguajes
naturales pueden entenderse como casos especiales del paradigma general.
La IA ha incorporado la teoría de la probabilidad a la gestión de la
incertidumbre, la teoría de la utilidad para definir objetivos y el
aprendizaje estadístico para ayudar a las máquinas a adaptarse a
circunstancias nuevas. Estos progresos han creado fuertes vínculos con
otras disciplinas que aplican conceptos similares, incluidas la teoría
del control, la economía, la investigación de operaciones y la
estadística.
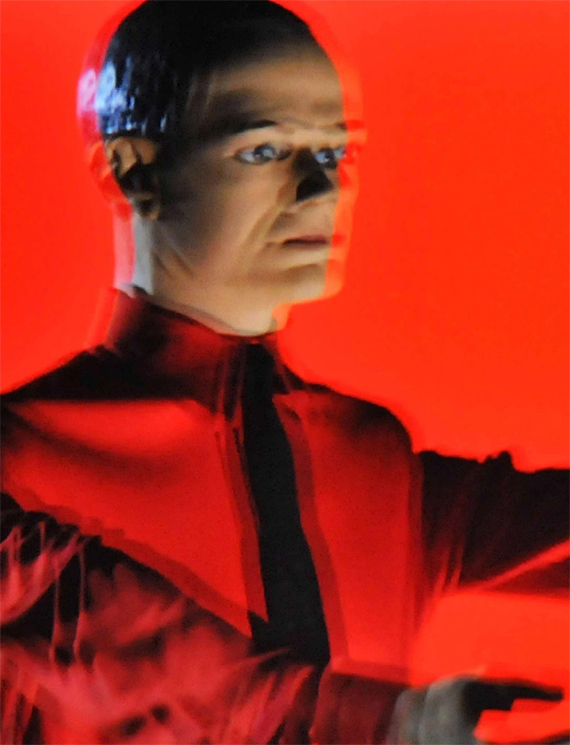
Vídeo
de la banda pionera de música electrónica alemana Kraftwerk durante su
actuación en la inauguración de su exposición retrospectiva Catalogue
12345678 en el Turbine Hall de la Tate Modern el 6 de febrero de 2013 en
Londres, Reino Unido
Los progresos en IA parecen
acelerarse. En los últimos años, debido en parte a los avances en el
aprendizaje de las máquinas, tareas como el reconocimiento de voz, la
identificación de objetos, la locomoción bípeda y la conducción autónoma
se han resuelto en gran medida. Cada nueva destreza alcanzada trae
consigo nuevos mercados potenciales y nuevos incentivos para seguir
invirtiendo en investigación, lo que conduce a un ciclo virtuoso que
impulsa la IA. En la próxima década es probable que asistamos a
progresos sustanciales en comprensión efectiva del lenguaje, lo que
conducirá a sistemas capaces de ingerir, sintetizar y contestar
preguntas sobre la suma total del conocimiento humano.
A pesar de todos estos avances,
seguimos lejos de la IA a nivel humano. Por ejemplo, no disponemos de
métodos prácticos para inventar conceptos útiles como «electrón» o
nuevas acciones útiles de alto nivel como «preparar diapositivas para la
clase de mañana». Esta última destreza es especialmente importante para
sistemas que operan en el mundo real, donde los objetivos que importan
pueden requerir miles de millones de acciones básicas de control motor.
Sin la capacidad de concebir ni razonar sobre acciones nuevas de alto
nivel, son imposibles la planificación y la actuación en las escalas
temporales que se manejan. Sin duda son necesarios más avances que no
sabremos describir hasta que nuestros esfuerzos por construir sistemas
IA polivalentes fracasen de maneras interesantes. La dificultad de
predecir estos avances implica que dar una estimación precisa de la
fecha en la que la IA alcanzará el nivel humano es imprudente. Sin
embargo, la mayoría de expertos cree que es probable que ocurra en el
presente siglo (Müller y Bostrom 2016; Etzioni 2016).
Es difícil exagerar la importancia
de un acontecimiento así. Todo lo que ofrece nuestra civilización es
consecuencia de la inteligencia; por tanto, el acceso a una inteligencia
sustancialmente mayor supondría una discontinuidad en la historia de la
humanidad. Podría conducir a soluciones de problemas como la
enfermedad, la guerra y la pobreza; al mismo tiempo, varios observadores
han señalado que los sistemas de IA superinteligentes pueden, por su
propia naturaleza, tener impactos a escala global que podrían ser
negativos para la humanidad de no estar bien diseñados.(1) La clave está
en definir el problema que nuestros sistemas de IA tienen que resolver,
para que podamos garantizar nuestra satisfacción con los resultados. Y
lo que nos jugamos es mucho.
Riesgos y refutaciones
Las preocupaciones
que suscita la IA superinteligente no son algo nuevo. Turing mismo, en
una comunicación por radio de 1951, sintió la necesidad de apuntar la
siguiente posibilidad: «Si una máquina puede pensar, es posible que
piense de manera más inteligente que nosotros, y entonces ¿dónde nos
coloca eso? Incluso si pudiéramos relegar a las máquinas a una posición
de servidumbre, por ejemplo desenchufándolas en momentos estratégicos,
deberíamos, como especie, extraer una lección de humildad […] Este nuevo
peligro […] es, sin duda, algo que puede causarnos preocupación».
Irving. J. Good (1965), que había trabajado con Turing durante la
Segunda Guerra Mundial, fue más allá y apuntó la posibilidad de sistemas
de IA que se automejoran. «Habría entonces, indudablemente, una
“explosión de inteligencia”, y la inteligencia del hombre quedaría muy
atrás.» El problema del control de la IA, por tanto, es cómo asegurarse
de que los sistemas con un grado arbitrariamente alto de inteligencia
permanecen bajo estricto dominio humano.
Parece razonable
ser cauteloso a la hora de crear algo mucho más inteligente que nosotros
mismos; sin embargo, necesitamos algo más que una sensación de
inquietud generalizada para reconducir de manera correcta la despiadada
presión científica y económica a la hora de construir sistemas cada vez
más capaces. Muchas novelas y películas han trasladado esta inquietud a
escenarios de máquinas conscientes espontáneamente malvadas, algo que es
muy improbable y, como fenómeno técnico a evitar, imposible de abordar.
De hecho, en la medida en que comprendemos el problema, la fuente de
dificultades más probable parece ser un fracaso en el alineamiento de
valores; a saber, que es posible que, sin darnos cuenta, dotemos a las
máquinas de objetivos que no se alinean correctamente con los nuestros.
Norbert Wiener (1960) lo expresó así: «Si usamos para nuestros fines una
agencia mecánica en cuyo funcionamiento no podemos interferir de manera
efectiva […] debemos asegurarnos de que el propósito que damos a la
máquina es el que de verdad deseamos».
Por desgracia, ni la IA
ni otras disciplinas construidas alrededor de la optimización de
objetivos (economía, estadística, teoría del control e investigación de
operaciones) tienen gran cosa que decir sobre cómo identificar los
propósitos que de verdad deseamos. En lugar de ello, asumen que los
objetivos son simplemente implantados en la máquina. La IA estudia la
capacidad de conseguir objetivos, no el diseño de estos. Y, como
descubrió el rey Midas, conseguir lo que uno desea no siempre es bueno.
Nick Bostrom (2014)
expone varios argumentos adicionales que sugieren que el problema no
tiene soluciones fáciles. El más relevante para el análisis de este
artículo lo debemos a Omohundro (2008), quien observó que entidades
inteligentes tenderán a actuar de maneras que preserven su propia
existencia. Esta tendencia no tiene nada que ver con el instinto de
autoconservación ni otros conceptos biológicos; simplemente, una entidad
no puede lograr sus objetivos si está muerta. Esto significa que la ya
citada confianza de Turing en la posibilidad de apagar la máquina no
procede. Según la argumentación de Omohundro, una máquina
superinteligente se las arreglará para anular la opción de apagado. Así
pues, tenemos un horizonte de máquinas superinteligentes cuyas acciones
son (por definición) impredecibles por parte de meros humanos, cuyos
objetivos especificados de forma imperfecta e incompleta pueden entrar
en conflicto con los nuestros y cuya motivación para preservar su propia
existencia como vía para cumplir esos objetivos puede resultar
insuperable.
Estos argumentos han
despertado una serie de objeciones, en especial por parte de
investigadores de IA. Las objeciones son reflejo de una actitud
defensiva natural, unida tal vez a una falta de imaginación sobre lo que
podrían hacer las máquinas superinteligentes. Nadie parece dispuesto a
estudiar esto con detenimiento (si a simple vista alguna de las
objeciones se antoja absurda, puedo asegurar que las hay más absurdas
aún y que las omito para no avergonzar a sus autores). Varias de estas
objeciones figuran en el reciente Informe AI100 (Stone et al. 2016),
mientras que otras las hacen individuos que participan en paneles de
debate en congresos de IA:
«La inteligencia artificial a nivel
humano, es decir, similar a la humana, es imposible», se trata de una
afirmación chocante cuando la hacen investigadores de IA que, desde
tiempos de Turing, han tenido que rebatir aseveraciones similares por
parte de filósofos y matemáticos. La afirmación, que no está
fundamentada en argumentos ni en pruebas, parece admitir que si la IA
superinteligente fuera posible, supondría un riesgo significativo. Es
como si un conductor de autobús, con la humanidad entera como pasajeros,
dijera: «Sí, estoy conduciendo hacia un precipicio, pero confiad en mí,
¡nos quedaremos sin gasolina antes de llegar!». La afirmación también
supone una apuesta temeraria en contra del ingenio humano. En el pasado,
hemos hecho apuestas semejantes a estas y hemos perdido. El 11 de
septiembre de 1933, el famoso físico Ernest Rutherford afirmó, con gran
seguridad: «Quien espere obtener una fuente de energía de la
transformación de estos átomos es que está en la luna». El 12 de
septiembre de 1933, el físico Leó Szilárd inventó la reacción nuclear en
cadena inducida por neutrones. Unos años después, tras haber demostrado
esta reacción en su laboratorio, Szilárd escribió: «Desenchufamos todo y
nos fuimos a casa. Aquella noche tuve pocas dudas de que el mundo se
dirigía hacia el sufrimiento».
«Es demasiado pronto para
preocuparse por ello.» El momento de preocuparse por un problema
potencialmente serio para la humanidad no depende de cuándo se producirá
dicho problema, sino de cuánto tiempo se necesita para idear e
implementar una solución que lo evite. Por ejemplo, si tuviéramos que
detectar un asteroide de gran tamaño que se predice que va a colisionar
con la Tierra en 2066, ¿diríamos que es demasiado pronto para
preocuparnos? Y si consideramos los peligros catastróficos globales del
calentamiento humano que se cree que sobrevendrán a finales del presente
siglo, ¿es prematuro emprender acciones para prevenirlos? Al contrario,
puede ser demasiado tarde. La escala temporal pertinente para la IA a
nivel humano es menos predecible, pero en absoluto eso quiere decir que,
al igual que la fisión nuclear, pueda llegar bastante antes de lo
esperado.
«Es como preocuparse por la
superpoblación en Marte» es una variación interesante de la afirmación
«Es demasiado pronto para preocuparse» y que trae a la cabeza una
analogía especialmente pertinente: no solo se trata de un riesgo muy
futuro y de fácil gestión, también es extremadamente improbable que
intentemos trasladar a miles de millones de personas a Marte. Sin
embargo, la analogía es falsa. Ya estamos dedicando recursos científicos
y técnicos ingentes para crear sistemas de IA cada vez más capaces. Así
que un plan para trasladar la raza humana a Marte sin pensar antes en
lo que respiraríamos, beberíamos o comeríamos al llegar allí, sería una
analogía más adecuada.
«La IA a nivel humano no es una
realidad inminente, así que no debemos preocuparnos». Es otra variación
de «demasiado pronto para preocuparnos», pero que atribuye las
preocupaciones sobre el control de la IA a la falsa creencia de que la
IA superinteligente es inminente. Esa objeción sencillamente confunde
los motivos de preocupación, que no se basan en la inminencia. Por
ejemplo, Bostrom (2014), escribe: «En este libro no argumentamos en
ningún momento que estemos en el umbral de un importante avance en IA, o
que podamos predecir con ningún grado de precisión cuándo se producirá
dicho avance».
«Nosotros somos los expertos, los
que construimos los sistemas de IA; confiad en nosotros.» Esta objeción
suele ir acompañada de una crítica a quienes plantean preocupaciones,
acusándolos de ignorar la realidad de la IA. Aunque es cierto que
algunos de los personajes públicos que han expresado preocupaciones,
como Elon Musk, Stephen Hawking y Bill Gates, no son expertos en IA, sí
están familiarizados con el razonamiento científico y tecnológico. Y
sería difícil argumentar que Turing (1951), Good (1965), Wiener (1960) y
Minsky (1984) no están cualificados para hablar de IA.
«No sois más que luditas.» Musk,
Gates, Hawking y otros (incluido, al parecer, quien esto firma)
recibieron en 2015 el premio Ludita del año que concede la fundación
para la Información sobre Innovación en las Tecnologías. Una definición
de ludita que incluye a Turing, Wiener, Minsky, Musk y Gate, algunos de
los principales contribuyentes al progreso tecnológico de los siglos xx y
xxi resulta, cuando menos, peculiar. Además, el epíteto refleja una
comprensión del todo errónea de la naturaleza de las preocupaciones
planteadas y el propósito de hacerlas públicas. Es como si se acusara de
luditas a los ingenieros nucleares si plantearan la necesidad de
controlar la fisión. Algunos objetores también emplean el término
«antiAI», que viene a ser como llamar «antifísicos» a los ingenieros
nucleares. El propósito de comprender y prevenir los riesgos de la IA es
asegurar que podemos hacer reales los beneficios. Bostrom (2014), por
ejemplo, afirma que el éxito a la hora de controlar la IA dará lugar a
una «trayectoria civilizadora que conduzca a un uso solidario y jubiloso
de la parcela cósmica de la humanidad».
«Vuestras predicciones
apocalípticas no tienen en cuenta los beneficios potenciales de la IA.»
Si la IA no tuviera beneficios potenciales, no habría interés económico o
social por impulsar su investigación, y por tanto no existiría el
peligro de lograr una IA comparable a la humana. Esta objeción es como
acusar a los ingenieros nucleares que trabajan en contención de no tener
nunca en cuenta los beneficios potenciales de la electricidad barata.
El triste hecho es que los beneficios potenciales de la energía nuclear
no han conseguido materializarse, en gran medida, precisamente porque no
se prestó la atención debida a los riesgos de contención en Three Mile
Island y Chernóbil.
«No se puede controlar la
investigación.» En la actualidad nadie sugiere que pueda limitarse la
investigación sobre IA, solo que hay que prestar atención al problema de
prevenir consecuencias negativas de sistemas mal diseñados. Pero, si es
necesario, podemos controlar la investigación: no diseñamos
genéticamente seres humanos porque los biólogos moleculares decidieron,
en un taller celebrado en Asilomar en 1975, que sería una mala idea,
aunque «mejorar las reservas de humanos» era, desde varias décadas
antes, el objetivo de numerosos investigadores del campo de la biología.
«No conviene mencionar los riesgos, puede afectar la financiación.» Véanse energía nuclear, tabaco, calentamiento global.
Además de estas objeciones en el
campo de las políticas a seguir, hay otras que proponen soluciones
simples para evitar las consecuencias negativas de la IA
superinteligente.
«En lugar de introducir objetivos
en el sistema, dejar que elija los que quiera.» No está nada claro cómo
solucionaría esto el problema. Los criterios de acuerdo a los cuales un
sistema de IA elegiría sus propios objetivos pueden muy bien
considerarse metaobjetivos, y de nuevo nos enfrentamos al problema de
cómo asegurar que conducen a comportamientos consistentes con el
bienestar humano. Tenemos que rectificar el timón, no tirarlo por la
borda.
«Los humanos más inteligentes
tienden a tener objetivos más loables y altruistas, lo mismo ocurrirá
con las máquinas superinteligentes.» Más allá del hecho de que quienes
defienden este argumento se consideran más listos que la mayoría, hay,
de hecho, escasísimas pruebas de la validez de la premisa de este
argumento, y la premisa no proporciona apoyo ninguno a la conclusión.
«No os preocupéis, tendremos
equipos humanos-IA que trabajarán en colaboración.» Una mala alineación
de los valores impide trabajar en equipo, así que esta solución pasa por
contestar antes a la pregunta de cómo solucionar el problema central de
alineamiento de valores.
«No hay que incluir en la ecuación
objetivos humanos como la autoconservación.» Véase la reflexión sobre el
argumento de Omohundro anterior. Para un robot que sirve cafés, la
muerte no es algo malo en sí mismo. Pero sí algo a evitar, porque es
complicado servir café si estás muerto.
«No pasa nada, se apaga y ya está.» Como si una entidad superinteligente no fuera a contar con esa posibilidad.
Soluciones
Bostrom (2014)
considera un número de propuestas técnicas más serias para resolver el
problema de control de la IA. Algunos, bajo el encabezamiento de
«oráculo de IA», proponen encerrar las máquinas en una suerte de
cortafuegos y extraer de ellas trabajo útil tipo pregunta-respuesta,
pero sin permitirles jamás intervenir en el mundo real. (¡Por supuesto
que, esto implica renunciar a los robots superinteligentes!) Por
desgracia, es poco probable que algo así funcione, pues todavía no hemos
inventado un cortafuegos que actúe de manera segura contra simples
humanos, y mucho menos contra máquinas superinteligentes. Otros hablan
de restricciones probadamente aplicables al comportamiento, pero
diseñarlas es como intentar escribir una ley fiscal sin resquicios (¡con
evasores fiscales superinteligentes además!),
¿Podríamos, en lugar de ello,
abordar la advertencia de Wiener? ¿Podemos diseñar sistemas de IA cuyos
propósitos no entren en conflicto con los nuestros, de manera que
nuestra satisfacción con su manera de comportarse esté asegurada? No es
algo nada sencillo, pero puede ser factible si seguimos tres principios
centrales:
El propósito de la máquina es
maximizar la puesta en práctica de valores humanos. Más concretamente,
no tiene un propósito propio ni un deseo innato de protegerse.
La máquina tiene una incertidumbre
inicial respecto a cuáles son esos valores humanos. Esto resulta más
crucial y, en cierto modo, elude el problema de Wiener. La máquina puede
aprender más sobre valores humanos sobre la marcha, claro, pero es
posible que nunca alcance total certidumbre.
Las máquinas pueden aprender sobre valores humanos observando las elecciones que hacemos los humanos.
Resulta que estos
tres principios, una vez incardinados en un marco matemático formal que
defina el problema que la IA está inherentemente obligada a resolver,
parecen permitir ciertos progresos en el problema de control de la IA.
En particular, al menos en casos simples, podemos definir una plantilla
para diseños de agentes probadamente beneficiosos bajo determinados
supuestos razonables (si no ciertos).
Aprendizaje de funciones de recompensa
Para explicar el
marco matemático, ser algo más precisos con la terminología ayuda. Según
Von Neumann y Morgenstern (1994), a cualquier agente racional puede
atribuírsele una función de utilidad U(s) que asigna un número real que
representa la deseabilidad de existir en un estado del mundo particular
cualquiera s. De modo equivalente, esta es la deseabilidad esperada de
las posibles secuencias de estado futuras que empiezan por s, asumiendo
que el agente actúa de forma óptima. (En investigación de operaciones,
esto a menudo se conoce por función de valor, un término que tiene un
significado distinto en economía.) Hay otra suposición posible de
preferencias estacionarias (Koopmans 1972), según la cual la
deseabilidad de una secuencia de estado cualquiera puede expresarse como
una suma (que probablemente decrece con el tiempo) de recompensas
inmediatas asociadas a cada estado de la secuencia. Por razones de
conveniencia, la función de recompensa R(s, a, s’) se define de manera
que sea la recompensa inmediata asociada a la transición del estado s al
estado s’ mediante la acción a. Por lo general, la función recompensa
proporciona una manera concisa de definir una tarea; por ejemplo, la
tarea de jugar al backgammon puede definirse especificando que la
recompensa sea = para todos los estados no terminales s’ y un número
entre -192 y +192 para transiciones a estados terminales (el valor
preciso dependerá del estado del cubo de doblar y de si el juego termina
de una manera normal, con gammon o con backgammon). La utilidad de un
estado de backgammon s, por otra parte, será en la mayoría de los casos
una función muy compleja de s, porque representa una expectativa de
secuencias de recompensa futuras respecto a todas los resultados
posibles de los dados que se produzcan durante lo que queda de partida.
Para una persona que está pasando un rato de disfrute en su jardín, las
recompensas de oler una rosa pueden ser positivas (siempre que no la
huela cien veces seguidas) y las de pincharse el dedo con las espinas
negativas, mientras que la utilidad de estar en el jardín en ese momento
dependerá de todas las recompensas futuras, y estas pueden variar
enormemente en función de si uno está a punto de casarse, de cumplir una
larga condena en la cárcel, etcétera.
En la medida en que sea posible
definir de manera concisa objetivos especificando funciones de
recompensa, el comportamiento puede explicarse de forma también concisa
infiriendo funciones de recompensa. Esta es la idea clave que subyace en
el llamado aprendizaje por refuerzo inverso (IRL, por sus siglas en
inglés; Russell 1998; Ng y Russell 2000). Un algoritmo IRL aprende una
función nueva observando el comportamiento de otro agente, del que se
asume que actúa en consonancia con dicha función. El IRL es la forma
secuencial de obtención de preferencias y está relacionado con el
cálculo estructural de PDM (procesos de decisión de Márkov, en
economía). Viendo a su dueño preparar café por la mañana, el robot
doméstico aprende algo sobre la deseabilidad de tomar café en
determinadas circunstancias, mientras que un robot de dueño inglés
aprenderá sobre la deseabilidad de tomar el té en cualquier ocasión.
Resolver problemas sencillos de control de IA
Cabría imaginar que
el IRL proporciona una solución sencilla al problema de alineamiento de
valores: el robot observa el comportamiento humano, aprende la función
de recompensa y se comporta de acuerdo a dicha función. Esta sencilla
idea presenta dos problemas. El primero es obvio: el comportamiento
humano (en especial por la mañana) a menudo transmite un deseo de tomar
café, y el robot puede aprender esto, pero ¡no queremos que el robot
quiera tomar café! Este defecto es fácil de solucionar; necesitamos
reformular el problema de alineamiento de valores de manera que el robot
siempre tenga el mismo objetivo de optimizar la recompensa para el
humano (el principio 1 expuesto anteriormente) y se vuelva más capaz de
hacerlo a medida que aprenda cuál es la función de recompensa humana.
El segundo problema es menos obvio y
menos fácil de solucionar. Al humano le interesa asegurar que el
alineamiento de valores se produzca de la forma más rápida y precisa
posible, de forma que el robot pueda ser útil al máximo y se eviten
errores potencialmente desastrosos. Sin embargo, actuar de forma óptima
en la adquisición de café limitando al robot a un papel pasivo puede no
ser la manera idónea de conseguir el alineamiento de valores. En lugar
de ello, el humano tal vez debería explicar los pasos necesarios para
preparar café, así como enseñar al robot dónde se guarda el café y qué
hacer si se deja demasiado tiempo la cafetera encendida, mientras que el
robot puede preguntar para qué sirve el botón de hacer espuma y probar a
preparar café bajo la supervisión de un humano, incluso si los primeros
resultados son imbebibles. Ninguna de estas posibilidades encaja en el
marco del IRL.
Si se extiende el aprendizaje
inverso por refuerzo de manera que incorpore como agentes tanto al robot
como al humano, entonces es posible formular y solucionar un problema
de alineamiento de valores, convirtiéndolo en un proceso de maximización
de recompensa cooperativo e interactivo (Hadfield-Menell et al. 2017a).
Más concretamente, un problema de aprendizaje inverso cooperativo por
refuerzo (CIRL, por sus siglas en inglés) es una partida para dos
jugadores con información parcial en la que el humano conoce la función
de recompensa(2) y el robot no, pero la recompensa del robot es idéntica
a la del humano. Por tanto, el CIRL encarna los tres principios
enunciados anteriormente. Las soluciones óptimas a este juego maximizan
la recompensa humana y pueden generar de forma natural instrucción
activa por parte del humano y aprendizaje activo por parte del robot.
En el marco del
CIRL, se puede formular y resolver el problema de desenchufar, es decir,
el problema de evitar que un robot inutilice su botón de apagado. (Así
Turing puede estar tranquilo.) Es seguro que un robot diseñado para
resolver el problema del CIRL quiere maximizar valores humanos, pero
también es seguro que no sabe con exactitud cuáles son. Ahora bien, el
robot se beneficia de hecho de que lo apaguen porque entiende que el
humano pulsará el interruptor para evitar que el robot haga alguna cosa
contraria a los valores humanos. Así, el robot tiene un incentivo
positivo para respetar el interruptor de apagado y este incentivo deriva
directamente de su incertidumbre respecto a los valores humanos.
Además, es posible demostrar que en algunos casos el robot es
probadamente beneficioso, a saber, la recompensa esperada por el humano
es mayor cuando hay un robot capaz de resolver problemas de CIRL con
independencia de cuál sea la función de recompensa real del humano
(Hadfield-Menell et al. 2017b).
El ejemplo del
interruptor de apagado sugiere algunas fórmulas para el diseño de
agentes controlables y nos proporciona al menos un caso de sistema de
beneficio probado. El enfoque general guarda cierta similitud con el
diseño de mecanismos de resolución de problemas en matemáticas, donde
uno trata de incentivar a otros agentes para que se comporten de maneras
que sean probadamente beneficiosas para el diseñador del mecanismo. La
diferencia fundamental es que aquí estamos construyendo a uno de los
agentes para que beneficie al otro.
El ejemplo de apagado funciona
debido al principio 2, es decir, que el robot debería tener
incertidumbre respecto a la verdadera función de recompensa del humano.
Por extraño que parezca, la incertidumbre respecto a la recompensa ha
sido ignorada casi por completo en IA, a pesar de que la incertidumbre
respecto al conocimiento del campo de acción y la interpretación de
sensores ha sido una preocupación central durante veinte años. La razón
puede ser que la incertidumbre respecto a la función de recompensa es
irrelevante en problemas de decisiones secuenciales estándar (procesos
de decisión de Márkov o MDP, MDP parcialmente observables o POMDP y
problemas de control óptimo), porque la política óptima con una función
de recompensa incierta es idéntica a la política óptima con una función
de recompensa definida equivalente al valor esperado de la función de
recompensa incierta. Sin embargo, esta equivalencia solo se mantiene
cuando el entorno no proporciona ulterior información sobre la verdadera
función de recompensa, que no es el caso de problemas de CIRL, donde
las acciones humanas revelan información sobre preferencias humanas.
Cuando el entorno sí puede proporcionar información adicional sobre la
función de recompensa, los agentes con incertidumbre respecto a esta
pueden presentar comportamientos que no podrían realizar sistemas de IA
tradicionales con funciones de recompensa fijas.
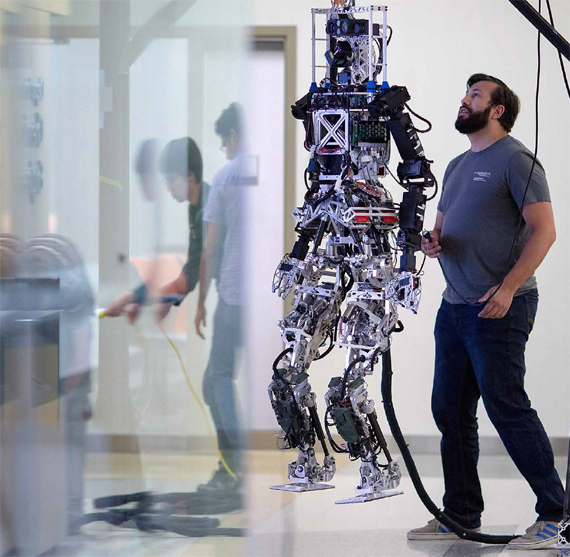
Un
miembro de Team Valor prueba el robot THOR durante la preparación del
Desafío Robótico (Robotics Challenge) de DARPA, la agencia de
investigación de proyectos avanzados de defensa en el TREC (laboratorio
de ingeniería y control de robótica terrestre) del Virginia Tech
En este punto, el lector
familiarizado con el concepto de aprendizaje por refuerzo (RL, por sus
siglas en inglés) podría aducir que la «señal recompensa» que recibe el
agente RL después de cada transición estado-acción-estado sí proporciona
información sobre la verdadera función de recompensa, porque da el
valor real de R(s, a, s’) para la transición producida. Así pues,
¿podría el aprendizaje por refuerzo ordinario constituir una base para
el alineamiento de valores si el humano se limita a suministrar una
señal de recompensa directamente al robot? ¡Por fortuna no! En primer
lugar, el humano puede no ser capaz de cuantificar la recompensa de
forma precisa, ni siquiera para transiciones específicas ya
experimentadas. En segundo lugar, el modelo formal de RL asume que la
señal de recompensa le llega al agente de fuera del entorno; pero el
humano y el robot son parte del mismo entorno, y el robot puede
maximizar su recompensa modificando al humano de manera que le
proporcione en todo momento una señal de recompensa máxima. Lo
indeseable de este resultado, conocido como wireheading o estimulación
directa (Muehlhauser y Hibbard 2014), pone de manifiesto un error de
base en la formulación estándar del RL. El error es que el entorno no
puede proporcionar una recompensa real al agente; tan solo información
sobre la recompensa. Así, un humano que emite una «señal de recompensa»
al robot no le está dando una recompensa, sino proporcionándole pruebas
(probablemente ruidosas) de sus preferencias en forma de una acción que
selecciona un número. Esta nueva formulación evita claramente el
problema de wireheading porque el robot solo saldrá perdiendo si
modifica la fuente de información para enmascarar la señal subyacente. Y
si la formulación estipula que el robot tiene que maximizar la función
de recompensa original, entonces modificar al humano de manera que tenga
una función de recompensa nueva más sencilla de maximizar no le hace
ningún bien al robot.
Consideraciones prácticas
He argumentado que
el marco para el aprendizaje inverso por refuerzo puede ser el primer
paso para una resolución teórica del problema de control en IA. Hay
también razones para creer que el enfoque puede funcionar en la
práctica. En primer lugar, hay ingentes cantidades de información
escrita y filmada sobre humanos haciendo cosas (y otros humanos
reaccionando). La tecnología necesaria para construir modelos de valores
humanos a partir de estos archivos estará disponible mucho antes de que
se creen sistemas de IA superinteligentes. En segundo lugar, existen
incentivos muy poderosos y a corto plazo para que los robots entiendan
los valores humanos: si un robot doméstico mal diseñado cocina al gato
para cenar porque no entiende que su valor sentimental excede con mucho
su valor nutricional, el sector de los robots domésticos quebrará. En el
campo de los asistentes personales digitales, que probablemente se
convertirá en un mercado importante antes de que termine la década, un
asistente que se adapta con rapidez a las preferencias complejas y
llenas de matices de su dueño presenta beneficios obvios.
-
Un enfoque basado en el aprendizaje
de valores a partir del comportamiento humano, no obstante, plantea
problemas evidentes. Los humanos son irracionales, incoherentes,
pusilánimes y computacionalmente limitados, de manera que sus acciones
no siempre reflejan sus valores (pensemos, por ejemplo, en dos humanos
que juegan al ajedrez; por lo general uno de ellos pierde, ¡pero no
adrede!). Los humanos también son diversos en cuanto a valores y
circunstancias, lo que quiere decir que los robots deben ser receptivos a
las preferencias individuales y mediar en conflictos de preferencias,
un problema tanto para científicos sociales como para ingenieros. Y
algunos humanos son malvados, así que el robot debe poder ser capaz de
filtrar valores de sistemas individuales que sean incompatibles con el
bienestar general.
-
Parece probable que
los robots puedan aprender de comportamientos humanos no racionales solo
con la ayuda de modelos cognitivos de humanos muy mejorados. ¿Y qué
pasa con el comportamiento indeseable? ¿Es posible evitar corromper a
nuestros robots sin imponer limitaciones adquiridas (y que por tanto
varían según las culturas) a los valores que estamos dispuestos a
permitir? Tal vez se pueda usar una versión del imperativo categórico de
Kant, según la cual una función de recompensa que asignara valor
negligible o negativo al bienestar de los demás carecería de
autoconsistencia, en el sentido de que si todos operaran con dicha
función de recompensa, entonces ninguno la obtendría.
Síntesis
He argumentado,
siguiendo a numerosos autores, que encontrar una solución al problema de
control de la IA es una tarea importante. Más concretamente y en las
sonoras palabras de Bostrom, «la tarea esencial de nuestra época».
También he argumentado que, hasta el momento, la IA se ha centrado en
sistemas capaces de tomar mejor decisiones, pero que esto no es lo mismo
que tomar decisiones mejores. Por muy excelentemente que maximice un
algoritmo, y por muy preciso que sea su modelo del mundo, las decisiones
de una máquina pueden ser estúpidas a los ojos de un humano normal y
corriente si su función de utilidad no está bien alineada con los valores humanos.
Este problema exige cambiar la
definición misma de IA, que debe dejar de ser un campo que se ocupa de
la inteligencia pura, con independencia del objetivo, y ser uno que se
ocupe de sistemas probadamente beneficiosos para los humanos. (Supongo
que también podríamos diseñar sistemas de IA para otras especies, pero
no creo que sea una prioridad ahora mismo.) Tomarse en serio el problema
ha dado lugar a nuevas maneras de enfocar la IA, sus propósitos y
nuestra relación con ella
-.
Notas
1. Existen otros
posibles riesgos del uso indebido de una IA cada vez más potente,
incluidos la vigilancia automática y la persuasión, las armas autónomas y
la disrupción económica; deben ser estudiadas en profundidad, pero no
son el tema del presente artículo.
2. Cabría
preguntarse: ¿por qué un humano que conoce la función de recompensa no
se limita a programarla en el robot? Aquí usamos «saber» en el sentido
restringido de como si uno conociera la función de recompensa, sin ser
necesariamente capaz de hacerla explícita. Es como cuando un humano
«conoce» la diferencia de pronunciación entre la letra g en gente y en
guante sin ser capaz de poner por escrito la regla ortográfica.
— Etzioni, O., «Are the Experts Worried About the Existential Risk of Artificial Intelligence?», en MIT Technology Review, 2016.
— Good, I. J., «Speculations Concerning the First Ultraintelligent Machine», en Alt, F. L. y Rubinoff, M. (eds.), Advances in Computers 6, Nueva York, Academic Press, 1965.
— Hadfield-Menell, D., Dragan, A., Abbeel, P. y Russell, S., «Cooperative Inverse Reinforcement Learning», en Advances in Neural Information Processing Systems 25, Cambridge, Massachusetts, The MIT Press, 2017a.
—
Hadfield-Menell, D., Dragan, A., Abbeel, P. y Russell, S., «The
off-switch», en la 31ª Conferencia AAAI sobre Inteligencia Artificial
(AAAI-17), 2017b.
— Koopmans, T. C., «Representation of Preference Orderings over Time», en McGuire, C. B. y Radner, R. (eds.), Decision and Organization, Ámsterdam, Elsevier/North-Holland, 1972.
— Minsky, M., «Afterword to Vernor Vinge’s novel, “True Names”», manuscrito inédito, 1984.
— Muehlhauser, L. y Hibbard, B., «Exploratory Engineering in Artificial Intelligence», en Communications of the ACM, vol. 57, n.º 9, 2014, pp. 32-34.
—
Müller, V. C. y Bostrom, N., «Future Progress in Artificial
Intelligence: A Survey of Expert Opinion», en Müller, V. C. (ed.), Fundamental Issues of Artificial Intelligence, Berlín, Springer, Synthèse Library, vol. 376, 2016.
— Ng., A. Y. y Russell, S., «Algorithms for Inverse Reinforcement Learning», Actas de la XVII Conferencia Internacional sobre Aprendizaje Automático, Stanford, California, Morgan Kaufmann, 2000.
— Omohundro, S. M., «The Basic AI Drives», en Proceedings of the First AGI Conference, IOS Press, 2008.
— Russell, S., «Learning Agents for Uncertain Environments (extended abstract)», en Proc. COLT-98, Madison, Wisconsin, ACM Press, 1998.
— Stone, P. et al., «Artificial Intelligence and Life in 2030», en One Hundred Year Study on Artificial Intelligence, informe del Panel de Estudio 2015, Universidad de Stanford, septiembre de 2016.
— Turing, A. M., «Can digital Machines Think?», 1951. Conferencia retransmitida por la BBC, transcripción en inglés en turingarchive.org
— Von Neumann, J. y Morgenstern, O., Theory of Games and Economic Behavior, 1ª ed., Princenton, Princeton University Press, 1944.
— Wiener, N., «Some Moral and Technical Consequences of Automation», en Science, vol. 131, n.º 3.410, 1960, pp. 1.355-1.358.
Copia y pega la cita con un formato específico o utiliza uno de los
enlaces para importar información a un gestor de bibliografía
Russell, S., "Inteligencia artificial de beneficios probados", en
El próximo paso. La vida exponencial, Madrid, BBVA, 2016.
“Amar educa”: El mensaje de Humberto Maturana a los educadores
En un discurso dirigido a educadores, el biólogo
chileno y premio Nacional de Ciencias, Humberto Maturana, habló del
verbo “amar” y el papel de éste en los procesos educativos.
Escrito por: Camila Londoño
Humberto Maturana, biólogo chileno, experto en epistemología y Premio
Nacional de Ciencias es reconocido en distintas partes del mundo por
sus investigaciones, las cuales han abierto nuevos paradigmas en la
ciencias naturales y en el entendimiento del desarrollo humano. Pero
además, por sus reflexiones sobre la educación, la infancia, el futuro de la humanidad y las emociones.
Maturana habla de rescatar las emociones dentro de una “deriva
cultural” donde éstas se han escondido y además hacer referencia al
verbo “amar” como una emoción que sostiene y funda lo humano.
En un encuentro con educadores en la Región de BioBío en Chile,
Maturana no sólo habló de la importancia de los contextos donde crecen
los niños y del papel de los adultos como piezas claves en el proceso de
crecimiento y transformación de los niños, también hizo énfasis en ese verbo “amar” desde un punto de vista educativo:
“Cuando decimos que amar educa, lo que decimos es que el
amar como espacio que acogemos al otro, que lo dejamos aparecer, en el
que escuchamos lo que dice sin negarlo desde un prejuicio, supuesto, o
teoría, se va a transformar en la educación que nosotros queremos. Como
una persona que reflexiona, pregunta, que es autónoma, que decide por sí
misma.
Amar educa. Si creamos un espacio que acoge, que escucha, en el cual
decimos la verdad y contestamos las preguntas y nos damos tiempo para
estar allí con el niño o niña, ese niño se transformará en una persona
reflexiva, seria, responsable que va a escoger desde sí. El poder
escoger lo que se hace, el poder escoger si uno quiere lo que escogió o
no, ¿quiero hacer lo que digo que quiero hacer?, ¿me gusta estar donde
estoy?”, son algunas de las preguntas que aparecen.
Para que el amar eduque hay que amar y tener ternura. El amar es
dejar aparecer. Darle espacio al otro para que tengan presencia nuestros
niños, amigos y nuestros mayores”.
La era de la perplejidad. Repensar el mundo que conocíamos
-
La revolución tecnológica
que estamos viviendo —la más acelerada de la historia— está generando
transformaciones que afectan al futuro de la humanidad. Las que parecían
constantes fundamentales de la especie humana: sus capacidades físicas y
mentales, su longevidad… etc., están ahora por definirse. Todo esto ha
abierto lo que este libro denomina una «era de la perplejidad», ante
cambios para los que no disponemos de guías ni menos aún de recetas para
actuar.
El impacto de la globalización, del avance tecnológico y de la
inseguridad que estos generan se refleja en las decisiones de las
personas y en el rumbo que está tomando nuestra sociedad. Un rumbo que
va a determinar nuestro futuro, en el sentido de hacernos más o menos
capaces de afrontar los retos y aprovechar las oportunidades que nos
ofrece el avance científico y tecnológico.
En este libro se desarrollan los grandes temas generales y se
analizan los cambios que la computación y la mayor disponibilidad de
información introducen en nuestras formas de percibir y entender las
cosas y en los imaginarios sociales, que marcan nuestra actitud y
nuestra reacción ante los acontecimientos a los que asistimos.
-
Todo esto subyace a los cambios que observamos en la política, con el
surgimiento de movimientos populistas o, más en general, la falta de
compromiso o la desafección para con las instituciones políticas y los
valores que sustentan las democracias actuales. En estos fenómenos
desempeñan un papel clave los nuevos medios de comunicación digitales,
las nuevas formas de activismo político digital y el auge de movimientos
que cuestionan de forma radical el paradigma económico y político
dominante.
-
En el plano supranacional y geopolítico se abordan la importancia de
incorporar un enfoque feminista a las relaciones internacionales (al
igual, por supuesto, que a todas las esferas de la actividad humana),
las nuevas formas de guerra, el reto geopolítico del complejo y diverso
ámbito arabomusulmán, el fin de la breve época del mundo unipolar, con
el surgimiento de poderes que cuestionan la hegemonía de Estados Unidos,
entre los que destaca China, o el papel futuro de Latinoamérica en el
ámbito global.
Las cuestiones económicas están en la base de la perplejidad, la
inseguridad y el descontento actuales. Por lo que en este libro se
discuten también el impacto de la globalización y del cambio tecnológico
sobre el crecimiento, el Estado de bienestar y, sobre todo, el empleo.
A partir de este análisis pueden plantearse las políticas económicas y
las formas de organización más adecuadas para aprovechar al máximo las
potencialidades de la revolución digital y minimizar los riesgos de que
se hagan realidad los temores de una sociedad cada vez más desigual, con
multitud de empleos en los que las personas se han visto desplazadas
por máquinas y en que incluso pierden el control de las decisiones,
individuales o colectivas.
-
Seguramente, esta revolución tecnológica exigirá un proceso de
transición complejo; pero también tenemos ante nosotros grandes
oportunidades para atender mejor las necesidades y demandas de las
personas: más crecimiento y empleo y más riqueza, mejor distribuida. Y,
sobre esta base, una vida más rica y plena para el conjunto de la
humanidad.
¿Qué le está pasando a nuestro mundo? Veintitrés grandes expertos internacionales presentan sus visiones de los grandes desafíos del siglo XXI.
- Contenido La revolución tecnológica y la globalización han abierto lo que este libro denomina "la era de la perplejidad".
Perplejidad ante cambios muy profundos que afectan no sólo a nuestras
vidas, sino también al futuro de la humanidad; cambian la economía, la
política, la sociedad y la vida diaria; y cambian incluso las que
parecían constantes fundamentales de la especie humana: sus capacidades
físicas y mentales, su longevidad e incluso su posición como especie
dominante, cuestionada por máquinas cada vez más inteligentes y ubicuas. La
era de la perplejidad. Repensar el mundo que conocíamos ofrece un
análisis multidisciplinar de los efectos de estos cambios, a partir de
las contribuciones de veintitrés autores de primer nivel mundial. Este libro es, sin duda, el primero en emplear un enfoque tan complejo e internacional, enlazando hábilmente las disciplinas más dispares para alimentar un debate imprescindible.
- Datos del autor NAYEF
AL-RODHAN · JOHN ANDREWS · MIGUEL ÁNGEL CENTENO · ADRIANA CONCONI
·ANDREW GAMBLE · FRANCISCO GONZÁLEZ · HELEN HESTER · JANNIS KALLINIKOS ·
ANDRÉS LAJOUS · ROBIN ELIZABETH MANSELL · EVGENY MOROZOV · JAN-WERNER
MÜLLER · DOUGLAS R. NELSON · DIANA OWEN · JOSÉ LUIS PARDO · ZIA QURESHI ·
ADAM SAUNDERS · SIMON SPRINGER · NICK SRNICEK · IAN STOREY · MARIANA
VIOLLAZ · RICHARD J. WHITE · MARYSIA ZALEWSKI
- La era de la perplejidad. Repensar el mundo que conocíamos es el décimo libro de la serie que BBVA dedica a la difusión del conocimiento sobre cuestiones fundamentales de nuestro tiempo.
En 2008, esta iniciativa editorial, que consiste en un lanzamiento al año, pasó a enmarcarse dentro del proyecto web
-
El
titulo no es muy acertado, cada epoca tiene su revolucion industrial,o
su revolucion del conocimiento, que deja perplejos modelos que van
quedando caducos, unas empresas, se adelantan a los cambios, con las
semillas que ya plantaraon hace 15 años, viendose ahora sus frutos,
otras empresas ahora se empiezan a enterar, otras van tarde y les toca
adaptarse y las pioneras como siempre actualmente ya estan en otros
proyectos, de los cuales veremos sus reslutados en los proximos 10 años.
-
Cuando los científicos descubrieron, a principios de los años 2000,
que era posible rociar células vivas a través de las boquillas de
impresoras de inyección de tinta sin dañarlas, se abrió todo un nuevo
campo de desarrollo en la biotecnología: la bioimpresión. Gracias a ello, ingenieros, biólogos, médicos y, por supuesto, empresarios, han empezado una carrera para fabricar órganos en 3D,
algo que tiene el potencial de atender mejor a la demanda de
trasplantes —120.000 órganos, sobre todo riñones, son trasplantados cada
año en el mundo, de acuerdo con los datos de la Organización Mundial de
la Salud (OMS). Oreja en 3D impresa por el equipo del Wake Forest Baptist Medical Center. Crédito: Wake Forest
Para imprimir un órgano desde cero hay que usar múltiples cabezales
de impresión para lanzar diferentes tipos de células junto con polímeros que ayudan a mantener la estructura en forma.
La impresora deposita, capa sobre capa, células que se unen y se
convierten en tejido vivo y funcional. Es lo que hizo el equipo del Wake
Forest Baptist Medical Centre, en Estados Unidos, al imprimir en 2016 partes del cuerpo humano como las orejas.
Esta tecnología todavía está en una fase demasiado experimental para
lograr ese objetivo final, pero investigadores de varios lugares ya
están manipulando tejidos de riñón e hígado, piel, huesos y cartílagos, así como los vasos sanguíneos necesarios para mantener vivas esas estructuras. Algunos de ellos han implantado orejas, huesos y músculos impresos en animales, y observaron cómo estos se integraron correctamente con cada organismo.
Ovarios protésicos que pueden concebir
El avance más prometedor en este sentido ocurrió el año pasado,
cuando un grupo de científicos de la Universidad de Northwestern, en
Chicago, logró imprimir ovarios protésicos para ratones, que pudieron concebir y dar a luz con la ayuda de estos órganos artificiales. Un corazón de silicona impreso en 3D. Crédito: ETH Zurich
En Chengdu (China) la compañía de biotecnología Sichuan Revotek
implantó con éxito una sección impresa de una arteria en un mono, un
logro considerado como el primer paso en los ensayos de una técnica
destinada al uso en humanos. Al otro lado del mundo, Organovo, una
empresa de San Diego (EEUU), anunció el año pasado que había trasplantado tejido impreso de hígado humano a ratones
y que dicho tejido había sobrevivido y funcionado “con normalidad”.
“Esperamos que, dentro de cinco años, podamos desarrollar esta técnica
para tratar problemas como insuficiencia hepática crónica, por ejemplo”,
afirma Benjamin Shepherd, responsable de los ensayos preclínicos en la
empresa. Organovo ya ofrece tejidos de riñón y de hígado bioimpresos a
la industria farmacéutica para evaluar con más precisión la eficacia y seguridad de algunos medicamentos. En Chengdu (China) se implantó con éxito una sección impresa de una arteria en un mono. Crédito: Sichuan Revotek
De acuerdo con Roots Analysis, una consultora de tecnología médica, los riñones en 3D podrían llegar a la industria de salud dentro de unos seis años.
“Los hígados, que tienen una tendencia natural a regenerarse, también
deberían llegar razonablemente pronto. Los corazones, con sus complejas
geometrías internas, tardarán más tiempo”, añade Kavya Verma,
investigadora experta en bioimpresión de la consultora.
Las compañías L’Oréal, Procter & Gamble y BASF se han unido para
trabajar en la impresión de piel humana. Su objetivo es usarla para
probar sus productos en busca de reacciones adversas. En el mismo
sentido, Johnson & Johnson ha sumado fuerzas con Tissue Regeneration
Systems, una firma en Michigan, para crear implantes en 3D con el fin de sanar defectos en huesos rotos.
La compañía estadounidense también se ha aliado con Aspect, una empresa
de biotecnología canadiense, para intentar imprimir meniscos de la
rodilla humana (las almohadillas de cartílago en forma de media luna que
separan el fémur de la tibia y actúan como amortiguadores entre estos
dos huesos). El gran desgaste de esta estructura a veces requiere una
intervención quirúrgica.
¿Jugando a ser Dios?
El potencial de la bioimpresión ya genera debates
éticos sobre su aplicación, desde temores sobre la calidad y la eficacia
de la piel artificial y los implantes hasta la acusación de que
permitirá a los humanos “jugar a ser Dios”. Científicos del Departamento
de Estudios de Ciencia, Tecnología e Innovación de la Universidad de
Edimburgo (Reino Unido) realizaron una extensa investigación sobre el tema
y consideran este argumento infundado. “Ya hay muchas tecnologías que
permiten a los seres humanos jugar a ser Dios, como la genética. La
bioimpresión permite a las personas fabricar pequeñas partes del cuerpo y
se usa para aplicaciones médicas”, afirma Gill Haddow, uno de los
investigadores del equipo.
Haddow considera que el principal obstáculo ético de la impresión de órganos en 3D es su coste.
Los más entusiastas de la tecnología afirman que los tejidos impresos
significarían que quienes esperan un trasplante dejarían de depender del
altruismo del prójimo y de la muerte de un extraño para disponer de un
órgano, pero Haddow considera este discurso bastante utópico. “Estamos
hablando de una tecnología extremadamente costosa que, de llegar
efectivamente a la industria médica, solo unas pocas personas podrán
permitirse pagar”.
El Instituto de Oncología de Vall d’Hebron (el VHIO) ha descubierto cómo acabar con las células tumorales durmientes
que se esconden mientras la medicina intenta acabar con un cáncer con
todo el arsenal terapéutico posible. Esas células preservadas a las que
la quimio no hace mella se encargan con el tiempo de que el tumor
reaparezca.
Una proteína llamada TET2 es una de las responsables de crear
reservas por todo el cuerpo de células progenitoras de diferentes
tejidos, como nuevas neuronas, nuevas células sanguíneas, la piel que
crece para cerrar una herida. Y es a la vez la principal responsable de
hacer lo mismo con las células tumorales en varios tipos de cáncer.
Coincidiendo a veces con el inicio de la quimioterapia, esta proteína
pone en marcha el sistema de conservación de las células tumorales
inmaduras, que permanecen dormidas y escondidas pero conservando toda su
capacidad maligna y resistentes a cualquier fármaco, porque no se
reproducen, que es el momento en el que los tratamientos actúan.
El talón de Aquiles de las durmientes
Al inhibir este factor TET2 se consigue detener la reaparición de las células tumorales latentes
El grupo de Células Madre y Cáncer del Instituto de Oncología
Vall d’Hebron ha logrado poner al descubierto al culpable. Y ha
encadenado a esta investigación de diez años otros proyectos de nuevos fármacos que inhiben ese factor culpable de que un tumor aparentemente curado reaparezca.
“Hemos podido comprobar que realmente el TET2 es el talón de Aquiles de
las células durmientes y que cuando ese factor se bloquea con fármacos,
se eliminan esas células responsables de las recaídas y también de la
resistencia a los tratamientos”, explica Héctor G. Palmer, investigador
principal de este largo estudio desarrollado en el VHIO, cuyos
resultados se publican en la revista The Journal of Clinical Investigation.
Paralelamente, su grupo ha puesto a punto una manera de identificar esta actividad del TET2, ha encontrado un biomarcador,
la señal que deja su actividad y que es visible en biopsias normales,
por lo que la prueba estaría al alcance de la mayoría de laboratorios
oncológicos.
Héctor G. Palmer y el equipo del VHIO que ha descubierto cómo eliminar las células tumorales dormidas
(KATHERIN WERMKE / VHIO)
Para Palmer y su equipo era casi una obsesión entender cómo
ocurría este fenómeno de células durmientes perfectamente preservadas.
La investigación se ha concentrado durante década en cómo matar el tumor
y ahora, muy recientemente, varios grupos empiezan a explicar sus
resultados en la comprensión de este fenómeno.
“Eran inmunes a los tratamientos, porque todos están diseñados para
frenar el crecimiento del tumor. Y ellas no crecen, se quedan escondidas
en el mismo sitio o se dispersan por todo el cuerpo. Parece algo
contradictorio en una célula tumoral, que se caracteriza precisamente
por crecer sin control. Pero esta preservación está perfectamente
ordenada, el factor TET2 actúa como un director de orquesta que impide
que la célula se divida y en cambio permanezca oculta y conserve todo su
potencial”.
MAGEN DE LAS CÉLULAS TUMORALES DURMIENTES Grupo de células
tumorales en crecimiento entre las que se esconden las célululas
latentes o durmientes que no se multiplican y que están señaladas con
una flecha. Se pueden identificar gracias a que retienen en su núcleo
una proteina artificial fluorescente que en la imagen se observa en
verde. Estas células minoriatarias están muy activas para TET2 y son
altamente resistentes a los tratamientos convencionales, convirtiendose
en la semilla de futuras recaidas.
(VHIO)
El punto flaco identificado por el grupo del VHIO actúa como un
supervisor del genoma del tumor, oxidando en puntos concretos del ADN.
Esa actividad “genera un mapa de óxido que hace que se comporte de una
forma u otra. El TET2 está más activo en unos tumores que otros y
tenerlo más activado supone un mayor riesgo de recaídas. Ese óxido se
puede cuantificar, de momento a través de la biopsia, pero en un futuro
en un análisis del ADN circulante. Pero sí sabemos ya el poder de esas
células dormidas. Podemos predecirlo”, explica el investigador
principal.
Los fármacos que están ensayando en el VHIO para inhibir el TET2
dejan intactos otros TET, el 1 y el 3, que son factores con funciones
parecidas a la hora de preservar células progenitoras (las que necesita
el cuerpo para reponer neuronas o sangre) pero que no tienen ningún
papel conocido en la protección de las tumorales dormidas, como el TET2.
“Que sepamos. Seguramente hay otros compañeros del TET2 implicados”,
apunta Palmer.
Cómo detectarla
Cuanta mayor es la actividad de la TET2, mayor es el riesgo de reaparición del tumor
“Lo hemos encontrado en hasta 19 tipos diferentes cáncer y en
un futuro habrá que iniciar el tratamiento para el cáncer combinándolo
con la inhibición de TET2. Necesitamos 5 años más”, dice Palmer.
La latencia, explican los investigadores. es una respuesta natural a
una situación adversa, como quizá el inicio del tratamiento contra el
tumor, “pero nos hemos dado cuenta de que al margen del tratamiento, los
tumores tienen tendencia a generar esas células latentes. Sucede por
defecto. Es un fenómeno más ancestral. Los tumores tiran de un mecanismo
similar al resto del organismo para tener sus reservas”.
La financiación
El papel clave de la asociación contra el cáncer
Las investigaciones que se llevan a cabo en el VHIO se
financian de muchas maneras. En este largo estudio sobre las células
tumorales durmientes y cómo acabar con ellas han participado en
distintos momentos desde la Fundación Fero al Instituto Carlos III, el
Ciberonc y Cellex. Pero la aportación más difícil la ha realizado la
Asociación Española contra el Cáncer. “Ellos se han atrevido a apostar
por pagar el contrato de una investigadora senior experta como Isabel
Puig, primera autora del estudio, durante diez años”, explica el
coordinador del estudio Héctor G. Palmer. Ese trabajo de alto nivel
investigador mantenido durante tantos años ha sido clave en la
consecución de los resultados “en la peor época para sostener una
investigación a largo plazo”.
El equipo de las células dormidas lo componen 10 personas dentro del
grupo de Células Madre y Cáncer del VHIO. La identificación de la pieza
clave en la generación de células tumorales durmientes ha incluido el
desarrollo de la tecnología necesaria para aislar los elementos e
identificarlos, que no existía, y ha generado datos fundamentales para
el conocimiento del gran reto de las recaídas.